Experimenteller KI-Anlagenberater
Verfügbar seit v0.17.2-b7; Messdatenberichte sind ab v0.17.2-b11 der Standard. Der Berater ist standardmäßig deaktiviert und muss separat aktiviert werden, auch wenn Smart aktiviert ist.
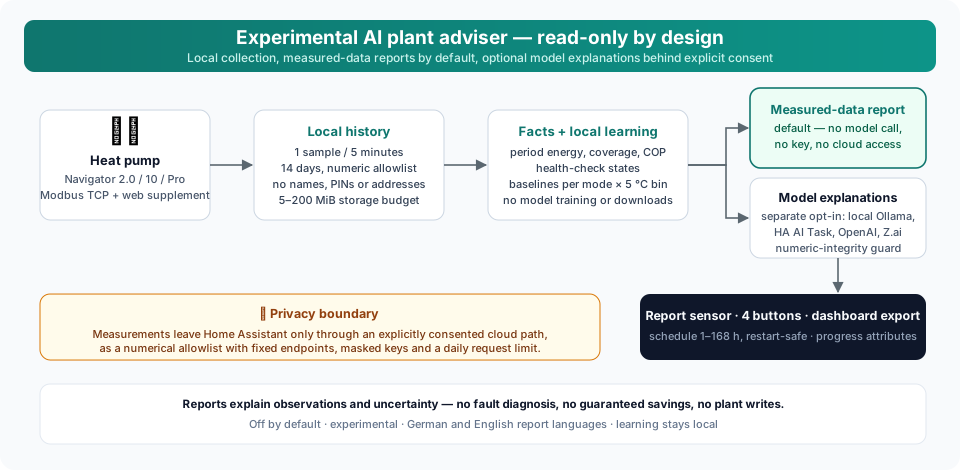
Er besitzt keine Home-Assistant-Steuerwerkzeuge, keine Modbus-Verbindung und keinen Schreibpfad zur Anlage. Er stellt die Anlage nicht für Assist, Google Assistant oder Alexa bereit.
Berichtsmodi
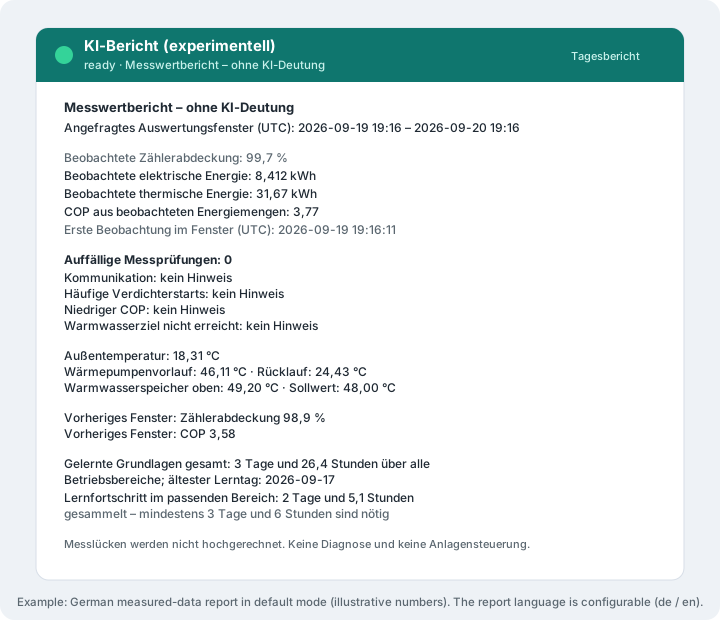
Der Standard ist ein deterministischer Messdatenbericht. Er zeigt die beobachtete Energie und Abdeckung des Zeitraums, aktuelle Temperaturen, einzelne Health-Check-Zustände, Energie/COP des vorherigen Zeitfensters und Vergleiche mit gelernten Baselines. Fehlende Daten werden als nicht verfügbar gekennzeichnet; lebenslange Energiezähler werden niemals als Verbrauch des Zeitraums ausgewiesen. Es wird kein Modell aufgerufen, es ist kein API-Schlüssel nötig, und es wird keine Cloud-Reservierung verbraucht. Zeitplanung, lokales statistisches Lernen, Speicherlimits und alle vier Berichts-Buttons funktionieren in diesem Modus.
Aktiviere freiformulierte, nicht vollständig überprüfbare KI-Erklärungen bei Bedarf separat. Übereinstimmende Zahlen können nicht belegen, dass ein Satz die richtige Messung, Einheit, den richtigen Zeitraum oder die richtige ursächliche Deutung verwendet. Der numerische Schutz lehnt einige unbelegte Aussagen ab, kann aber keine Bedeutung prüfen. Keiner der beiden Modi liefert eine Fehlerdiagnose oder eine automatische Optimierungssteuerung. Das Abschalten dieses Schalters ersetzt gespeicherte Modelltexte zusätzlich durch Messdatenberichte, wobei die ursprünglichen Fakten und Zeitstempel erhalten bleiben. Ein Upgrade auf Beta 11 lässt diesen neuen Schalter deaktiviert; Anbieter-Einstellungen bleiben erhalten.
Einrichtung
- Öffne Einstellungen → Geräte & Dienste → IDM Heatpump → Konfigurieren.
- Wähle auf jeder Setup-Tiefe KI-Berater (experimentell, schreibgeschützt) aus und aktiviere ihn.
- Wähle die Berichtssprache (
deoderen). Lasse freiformulierte Erklärungen deaktiviert für Berichte ohne Modell. Konfiguriere lokales Ollama oder einen der unten beschriebenen Anbieter nur, wenn du Erklärungen aktivierst. Die Integration installiert oder lädt keine Modelle herunter. - Aktiviere optional Lokale Betriebs-Baselines lernen, wähle ein Speicherbudget (5–200 MiB, Standard 20), ein automatisches Intervall (0 = manuell, 24 = täglich, 168 = wöchentlich) und den Berichtstyp, der automatisch erstellt werden soll. Benachrichtigungen haben einen eigenen Schalter und sind standardmäßig deaktiviert.
- Prüfe die Einstellungen und speichere. Das logische Gerät iDM KI-Anlagenberater enthält den Berichts-Sensor, Lern-/Speicher-/Abdeckungs-/COP-Sensoren und vier Berichts-Buttons. Es nutzt auf HA 2026.9+ ein untergeordnetes Gerät, mit einem Fallback über verknüpfte Geräte auf 2026.8 – unabhängig von der allgemeinen Einstellung für die optionale Gerätegruppierung.
Für Ollama werden nur literale private LAN- oder Loopback-IP-Adressen akzeptiert.
Hostnamen, öffentliche Adressen, eingebettete Zugangsdaten, URL-Pfade und Redirects
werden abgelehnt. Loopback bedeutet der Home-Assistant-Host bzw. -Container, nicht
ein anderer Server. HTTPS nutzt Zertifikatsvalidierung. Der Ollama-Endpunkt muss von
HA aus erreichbar sein. Cloud-Modellnamen und entfernte Modell-Metadaten werden
abgelehnt, bevor Messungen gesendet werden. Halte den Server vertrauenswürdig und
lokal; deaktiviere auf diesem Server zusätzlich erwägensweise die Cloud-Funktionen
über OLLAMA_NO_CLOUD=1, wie in der Ollama-FAQ
dokumentiert. Ein von der Administration kontrollierter Proxy kann Datenverkehr
außerhalb des LANs weiterleiten; HA kann den Server intern nicht prüfen.
Eine vollständige Schritt-für-Schritt-Anleitung zur Ollama-Installation — als Home-Assistant-Add-on, Docker oder bestehender Server — inklusive Modellwahl und gemessenen Hardware-Erwartungen steht auf der Seite Lokale Ollama-Einrichtung.
Home Assistant AI Task (empfohlen, v0.17.2-b10)
Wenn freiformulierte Erklärungen ausdrücklich aktiviert sind, verwende eine bestehende
ai_task-Entität zur Datenerzeugung, statt in IDM einen weiteren
API-Schlüssel einzugeben. Konfiguriere Anbieter, Modell und Ausgabegrenzen in der
Home-Assistant-Integration dieser Entität. Wähle dann Home Assistant AI Task
(empfohlen) in den Optionen des IDM-Beraters, wähle die Entität explizit aus,
erlaube das Senden der ausgewählten Betriebsdaten und speichere. Cloud-Modell-/
Schlüsselfelder werden auf diesem Weg nicht verwendet. Bestehende lokale
Ollama-Konfigurationen werden nie automatisch migriert.
Die Seite mit globalen KI-Einstellungen, die unter den AI-Einstellungen von Home Assistant angezeigt wird, analysiert die Wärmepumpe nicht selbst. IDM ruft die ausgewählte Aufgabe explizit auf; das Ändern der global bevorzugten Entität von HA kann den IDM-Anbieter daher nicht unbemerkt umschalten. Verwende eine Aufgabe zur Datenerzeugung; reine Bild-Aufgaben sind nicht geeignet.
Jeder Bericht startet eine neue HA-Task-Sitzung mit llm_api=None, ohne Anhänge
und ohne von IDM bereitgestellte Assist-/Steuerwerkzeuge. Verwende
vertrauenswürdige Anbieter-Integrationen, die den AI-Task-Vertrag von HA einhalten.
Deaktiviere für diesen reinen Messdaten-Anwendungsfall optionale Websuche- und
Code-Werkzeuge in der Anbieterkonfiguration. Dieselbe Fakten-Allowlist, das lokale
Lernen, der Berichtsschutz, der Zeitplan und das Dashboard bleiben erhalten.
Das gespeicherte Tagesbudget zählt Task-Starts, nicht die internen HTTP-Aufrufe des Anbieters. Anbieter-Wiederholungen, Modell-Token-Limits, Transporteinstellungen, Aufbewahrung, zusätzliche Prompts und anbieterseitige Werkzeuge werden von dieser Integration gesteuert; die 2.048-Token-/64-KiB-HTTP-Grenzen des direkten Adapters gelten nicht für HA-Tasks. IDM begrenzt seine Fakten weiterhin auf 12 KB, wartet bis zu 120 Sekunden und akzeptiert höchstens 6.000 Textzeichen. Konfiguriere die Abrechnungssteuerung des Anbieters separat.
OpenAIs offizielle HA-Integration benötigt einen OpenAI-API-Schlüssel. Ein Z.ai-Schlüssel kann dort nicht verwendet werden. Nutze einen kompatiblen, vertrauenswürdigen AI-Task-Anbieter oder die unten beschriebene direkte Z.ai-Alternative. Lokales Ollama und direkte Anbieter bleiben verfügbar, wenn kein passender HA-Task existiert. Ein automatischer Anbieter-Fallback findet nicht statt.
Optionale Cloud-Berichte (v0.17.2-b10)
Messdatenberichte bleiben der Standard. Für optionale freiformulierte Erklärungen
ist Ollama die anfängliche Anbieterauswahl. OpenAI und Z.ai sind experimentelle
Opt-in-Anbieter. Wähle unter Konfigurieren → KI-Berater openai oder zai,
erlaube die Cloud-Datenübertragung ausdrücklich, gib eine von deinem Konto
unterstützte Modell-ID ein und gib den zugehörigen API-Schlüssel ein. Die OpenAI-API
nutzt eine separate API-Abrechnung; ein ChatGPT-Abo ist kein API-Schlüssel. Z.ai
verwendet seinen allgemeinen Model-API-Endpunkt, nicht seinen Coding-Plan-Endpunkt.
Modellzugriff und Abrechnung hängen von deinem Anbieterkonto ab.
Du kannst Cloud-Einstellungen speichern, bevor du einen Schlüssel eingibst; Berichte
schlagen dann kontrolliert fehl (fail closed). Jeder Anbieter hat ein eigenes
Passwortfeld. Ein leeres Feld erhält den gespeicherten Schlüssel dieses Anbieters;
ein einzelnes - löscht ihn. Gespeicherte Schlüssel werden nie vorbefüllt. Sie
liegen in der HA-Konfiguration und können in HA-Backups enthalten sein, werden aber
aus der Integrations-Diagnose entfernt. Schütze Konfiguration und Backups wie
Zugangsdaten.
IDM liefert nur allowlistete numerische Temperaturen, den Betriebsmodus, Energie-/COP-/Abdeckungszusammenfassungen des Zeitraums, lokale Baseline-Statistiken und explizite Health-Check-Zustände. Keine Entitäts-/ Gerätenamen, Netzwerkadressen, Seriennummern, Web-PINs, rohen historischen Samples, lebenslangen Energiezähler oder HA-Konfiguration werden gesendet. Lokale Historie und Lernen bleiben auf HA. Betriebsmessungen können dennoch Rückschlüsse auf den Haushalt zulassen. Die Verarbeitungs- und Aufbewahrungsrichtlinien des Anbieters gelten; Cloud-Nutzung ist nicht mit lokaler Verarbeitung gleichzusetzen.
Bei direkten Adaptern sind Endpunkte feste HTTPS-URLs, die Zertifikatsvalidierung
bleibt aktiviert, Redirects werden abgelehnt, und es gibt keine Werkzeuge,
Websuche, Dateien, automatischen Wiederholungen oder Fallback auf einen anderen
Anbieter. OpenAI-Anfragen verwenden store: false, was keine vollständige
Nicht-Speicherung beim Anbieter zusichert. Siehe
OpenAI-Datenschutzkontrollen
und Z.ai-API-Dokumentation.
Das Standardbudget beträgt 2 Anfragen pro UTC-Tag pro Integrationseintrag, anpassbar von 1 bis 24. Reservierungen werden vor dem Senden gespeichert und überleben Reloads/Neustarts; fehlgeschlagene Anfragen verbrauchen ebenfalls eine Reservierung. Ein Speicherfehler oder ein fehlerhaft formatiertes Budget blockiert Cloud-Aufrufe. Ein Zurückstellen der Uhr setzt Reservierungen nicht zurück. Eingabefakten sind auf 12 KB begrenzt, die angeforderte Ausgabe auf 2.048 Token (einschließlich Reasoning, wo der Anbieter es mitzählt), Antwortkörper auf 64 KiB und Anfragen auf 120 Sekunden. Dies begrenzt die Nutzung, nicht einen exakten Geldbetrag. Konfiguriere die Abrechnungssteuerung zusätzlich beim Anbieter. Erhöhe Ausgabebudgets nicht nur, um unvollständige Antworten zu verbergen: inkompatible oder abgeschnittene Antworten werden abgelehnt.
Wenn freiformulierte Erklärungen aktiviert sind, verwenden die manuellen Buttons und
das optionale Intervall den ausgewählten Anbieter. Andernfalls erzeugen sie
Messdatenberichte lokal. Der Berichts-Sensor stellt cloud_budget_day_utc,
cloud_requests_reserved, cloud_budget_available_today (seit v0.17.2-b13, wahr,
sobald der UTC-Tag über den letzten Reservierungstag hinaus fortgeschritten ist)
und den Anbieter innerhalb jedes gespeicherten Berichts bereit. Ergebnisse
erscheinen auf demselben KI-Gerät und Dashboard wie lokale Berichte. Ein
Anbieterwechsel ändert nie Anlageneinstellungen. Wähle erneut ollama, um zu
lokalen Berichten zurückzukehren; dessen URL- und Modell-Einstellungen bleiben
erhalten. Der numerische Schutz gilt für beide Wege, aber freiformulierte
Erklärungen können trotzdem falsch sein. Kein Modell führt Anlagenaktionen aus.
Verfügbare Berichte
| Bericht | Umfang |
|---|---|
| Täglich | Rollierende letzte 24 Stunden, mit den vorangegangenen 24 Stunden als Kontext |
| Wöchentlich | Rollierende letzte sieben Tage, mit den vorangegangenen sieben Tagen |
| Health | Aktuelle Diagnose-Flags und fehlende Daten, mit 24-Stunden-Kontext |
| Effizienz | Beobachtete elektrische/thermische Energie und berechneter COP, mit 24-Stunden-Kontext |
Berichte erklären Beobachtungen und Unsicherheit. Sie empfehlen keine Sollwertänderungen, garantieren keine Einsparungen und führen keine Aktionen aus. Die Health-Flags sind die bestehenden regelbasierten Prüfungen, keine von einem KI-Modell erfundenen Diagnosen.
Historie und Datenqualität
Der Berater speichert höchstens ein numerisches Sample alle fünf Minuten und höchstens vierzehn Tage lokale Historie, solange die Funktion aktiviert ist. Die Erfassung läuft auf dem Konfigurationseintrag: Das Deaktivieren oder Entfernen der Berichts-Sensor-Entität stoppt weder Historie-Erfassung, lokales Lernen noch geplante Berichte (seit v0.17.2-b12). Er speichert Temperaturen und kumulative elektrische/thermische Zähler. Er importiert keine Recorder-Historie, daher kann eine Neuinstallation nicht sofort einen vollständigen Tag oder eine vollständige Woche liefern. Energiezähler erfordern die Smart-Statistiken; ohne sie fehlen Energie- und COP-Summen ausdrücklich.
Berücksichtigt werden nur Zählerintervalle bis fünfzehn Minuten mit gültigen, steigenden Zählern. Lücken, Zählerresets und nicht verfügbare Daten werden ohne Extrapolation ausgeschlossen. Der Abdeckungsprozentwert beschreibt beobachtete Zählerintervalle, nicht den Nachweis durchgehender Leistungsmessungen: Die zugrunde liegenden Energie-Statistiken schließen ebenfalls ungültige Abfrage-Lücken aus. Aktuelle Messwerte, die älter als fünfzehn Minuten sind, werden ausgeschlossen. Zeiträume sind rollierende UTC-Intervalle, keine lokalen Kalendertage. Heiz- und Warmwasserenergie werden nicht getrennt. Es gibt keine Wetter- oder Tarifvorhersagen.
Anfragen enthalten nur ausgewählte numerische Messwerte, boolesche Health-Flags, berechnete Zeitraumzusammenfassungen und feste Einschränkungen. Sie enthalten nie die Wärmepumpen-Adresse, PIN, Seriennummer, Entitätsnamen, andere HA-Geräte, Dokumente oder beliebige Nutzerfragen. Die Serveradresse wird aus der Diagnose entfernt. Modellausgaben sind rein textuell und werden nie ausgeführt.
Anzeige und Aktionen
Der Sensor KI-Bericht (experimentell) verwendet idle, generating, ready
oder error als Zustand. Attribute sind unter anderem report, generated_at,
report_type, facts, error und history_samples. Vier Buttons fordern die
jeweiligen Berichte an; sie ändern keine Wärmepumpen-Einstellungen. Im reinen
Web-Betrieb verwendest du die unten stehende Aktion, da die Button-Plattform nicht
geladen wird.
Die Aktion idm_heatpump.generate_ai_report benötigt eine explizite entry_id und
akzeptiert report_type: daily, weekly, health oder efficiency (Standard
daily). Wähle im Aktions-Editor den IDM-Eintrag aus. Die optionale Antwort
enthält den Bericht, den Zeitstempel und die Eingabefakten.
Pro Eintrag läuft höchstens eine Anfrage, mit einem Mindestintervall von sechzig Sekunden und einem 300-Sekunden-Timeout (seit v0.17.2-b9). Automatische Berichte sind standardmäßig deaktiviert. Modellinferenz erfordert zusätzlich den Schalter für freiformulierte Erklärungen. Setze das integrierte Intervall auf 1–168 Stunden, um sie zu aktivieren. Der erste Lauf erfolgt ein Intervall nach der Aktivierung. Der nächste fällige Zeitpunkt überlebt Neustarts; verpasste Läufe werden übersprungen, ohne eine Welle von Nachhol-Anfragen. Intervalle messen vergangene Stunden, nicht lokale Kalenderzeit: 24 Stunden können über eine Zeitumstellung hinweg um eine Stunde wandern. Ein manueller Bericht verschiebt den Zeitplan nicht. Fehlschläge warten bis zum nächsten Intervall.
Füge den Sensor und die Buttons über die Entitätsauswahl zu deinem Dashboard hinzu. Eine optionale Markdown-Karte kann die Ausgabe als maskierten Klartext anzeigen:
type: markdown
title: AI plant report — experimental
content: >-
  <pre>{{ state_attr('sensor.REPLACE_WITH_YOUR_AI_REPORT', 'report')
  | default('No report yet', true) | e }}</pre>
Ersetze die Beispiel-Entitäts-ID durch den tatsächlichen Berichts-Sensor. Halte
seinen Zustand und Zeitstempel sichtbar: Nach einer fehlgeschlagenen Anfrage bleibt
der letzte erfolgreiche Bericht mit seinem ursprünglichen Zeitstempel erhalten.
Das letzte erfolgreiche Ergebnis jedes der vier Berichtstypen überlebt Neustarts,
einschließlich Fakten, Zeitstempel und Qualitäts-Flags. Das Attribut reports
enthält alle vier Ergebnisse. Berichtstext und Fakten werden vom Recorder
ausgeschlossen, um große Duplikate zu vermeiden; kompakte Metrik-Zustände können
grafisch dargestellt werden.
Das Deaktivieren der Funktion stoppt die Erfassung und bricht eine laufende Anfrage ab. Die gespeicherte numerische Historie bleibt lokal verfügbar, wenn sie innerhalb ihres Aufbewahrungszeitraums erneut aktiviert wird. Die Wärmepumpe läuft unabhängig vom KI-Server weiter.
Fehlerbehebung
Wenn kein Bericht erscheint, prüfe den Funktions-Schalter, die Erreichbarkeit von HA aus, den exakten Namen des installierten Modells und das Fehler-Attribut des Sensors. Ein lokales GGUF-Completion-Modell ist erforderlich; ein Embedding-Modell kann keine Berichte schreiben. Antworten mit Werkzeugen, fehlerhaftem Inhalt, übermäßiger Größe oder Token-Limit-Abbruch werden abgelehnt. Warte, bis eine aktive Anfrage abgeschlossen ist, bevor du es erneut versuchst. Behandle einen alten gespeicherten Bericht oder eine unvollständige Historie nicht als frische, vollständige Einschätzung.
Dashboard und Lernen
Führe idm_heatpump.export_ai_dashboard mit ausgewähltem Integrationseintrag aus.
Kopiere das zurückgegebene dashboard-Objekt in den Raw-Konfigurations-Editor
eines neuen Dashboards. Es löst die aktuellen Entitäts-IDs auf, einschließlich
umbenannter Entitäten. Es enthält vier Berichtskarten, manuelle Buttons,
Datenabdeckung, beobachteten COP, Lernstatus und Speicher-Historie. Kein
bestehendes Dashboard wird überschrieben. Der Berichts-Sensor stellt außerdem
next_run (UTC-Unix-Zeitstempel) und seit v0.17.2-b13 next_run_utc (derselbe
Zeitpunkt als ISO-Zeitstempel für Dashboards), storage_limit_mib und
history_samples bereit.
Das Lernen ist ein statistischer Vergleich, kein LLM-Fine-Tuning. Es speichert tägliche Energieaggregate getrennt nach Heizen, Kühlen und Warmwasser sowie Außentemperatur-Bins von fünf Grad. Leerlauf, Abtauen, Moduswechsel, Zählerresets, veraltete Messwerte und Lücken werden ausgeschlossen. Beobachtungen an beiden Enden eines Intervalls können nicht beweisen, dass zwischen ihnen kein kurzer Moduswechsel stattfand. Eine Baseline erfordert mindestens drei frühere Tage und sechs beobachtete Stunden im passenden Bin. Der Vergleich für heute erfordert zusätzlich eine beobachtete Stunde. Der Lernstatus-Sensor zeigt diesen Fortschritt (seit v0.17.2-b13): Seine Attribute listen die gesammelten Tage und Stunden neben den erforderlichen Schwellenwerten auf, dazu Modus und Außen-Bin, und Messdatenberichte ergänzen eine Fortschrittszeile, solange die Baseline noch erfasst wird. Seit v0.17.2-b14 zeigen derselbe Sensor und Bericht auch die modusunabhängigen Summen — Tage, Stunden, Buckets, gelernte Betriebsmodi und den ältesten Lerntag —, sodass der Fortschritt sichtbar bleibt, während die Anlage im Leerlauf läuft und kein aktueller Betriebsmodus existiert. Daten des aktuellen Tages trainieren nie ihre eigene Baseline. Unterschiedliche Vorlauftemperaturen, Lasten und andere unbeobachtete Bedingungen können eine Abweichung weiterhin erklären; eine Baseline-Abweichung ist keine Fehlerdiagnose und keine Einsparungsgarantie.
Es gibt höchstens 4.034 detaillierte Samples (14 Tage) und 4.096 tägliche Lern-Buckets (bis zu 365 Tage). Alte Daten werden automatisch entfernt; detaillierte Daten werden zu kompakten täglichen Lernsummen, wenn Lernen aktiviert ist. Das gewählte Speicherlimit ist eine Obergrenze, keine Reservierung: Der Berater füllt nicht 20 MiB, nur weil sie verfügbar sind. Ein Absenken entfernt zuerst die ältesten Details vor den Lernsummen und erhält die neuesten Berichte. Der Speicher-Sensor ist eine konservative JSON-Größenschätzung inklusive Overhead, nicht die exakte Plattenspeicherbelegung. Modelldateien, HA-Recorder und Backups liegen außerhalb dieses Budgets. Es werden keine Embeddings, keine Vektordatenbank und kein neuer Modell-Download benötigt.
Qualitäts-Flags kennzeichnen Teilabdeckung und veraltete Eingaben. Seit Beta 8
führen unbelegte numerische Aussagen dazu, dass die gesamte Modellantwort verworfen
und durch einen klar gekennzeichneten Bericht ersetzt wird, der direkt aus den
Zeitraum-Fakten erzeugt wird. Prozentwerte werden gegen Prozentfelder geprüft, nie
gegen unabhängige Temperaturen oder Zähler. Berichte älterer Versionen werden
ebenfalls in diese reinen Messberichte umgewandelt; ihre Zeitstempel, Fakten und
Lern-Historie bleiben erhalten. Das Feld quality.output_source unterscheidet
ai von facts. Die Aktions-Antwort enthält dieses Qualitätsobjekt. Abgelehnte
Texte werden nicht gespeichert. Übereinstimmende Zahlen beweisen weiterhin nicht,
dass ein Satz sie korrekt verwendet: model_text_verified bleibt false.
Konservative Prüfungen können auch eine an sich vernünftige Modellantwort
ablehnen. Dieser Schutz ist keine Fehlerdiagnose und kein vollständiger
semantischer Faktencheck.
Optionale Benachrichtigungen nutzen eine lokale dauerhafte HA-Benachrichtigung pro Anlage, nur für gemessene Health-Flags nach Abschluss eines Berichts. Identische Flags wiederholen sich nicht; neue Meldungen haben eine Abklingzeit von zwölf Stunden. LLM-Vermutungen lösen nie Benachrichtigungen aus. Dies aktiviert keine sprachgesteuerte Offenlegung oder Steuerung der Anlage.
Größere lokale Modelle
Ein größeres Modell kann auf CPUs oder integrierten GPUs deutlich mehr Zeit benötigen. Berichte haben eine Gesamtfrist von fünf Minuten, einschließlich Modellvalidierung und -laden, und ein Verbindungs-Timeout von zehn Sekunden. Die Inferenz bleibt asynchron; überlappende Berater-Anfragen werden abgelehnt, und das Entladen der Integration bricht die Generierung ab. Halte das vorherige Modell verfügbar, bis ein repräsentativer Bericht auf der Ziel-Hardware abgeschlossen ist. Modelldateien und Laufzeit-RAM sind getrennt vom konfigurierten 5–200-MiB-Budget der Lern-Historie. Ein größeres Modell garantiert keine genaueren Erklärungen.